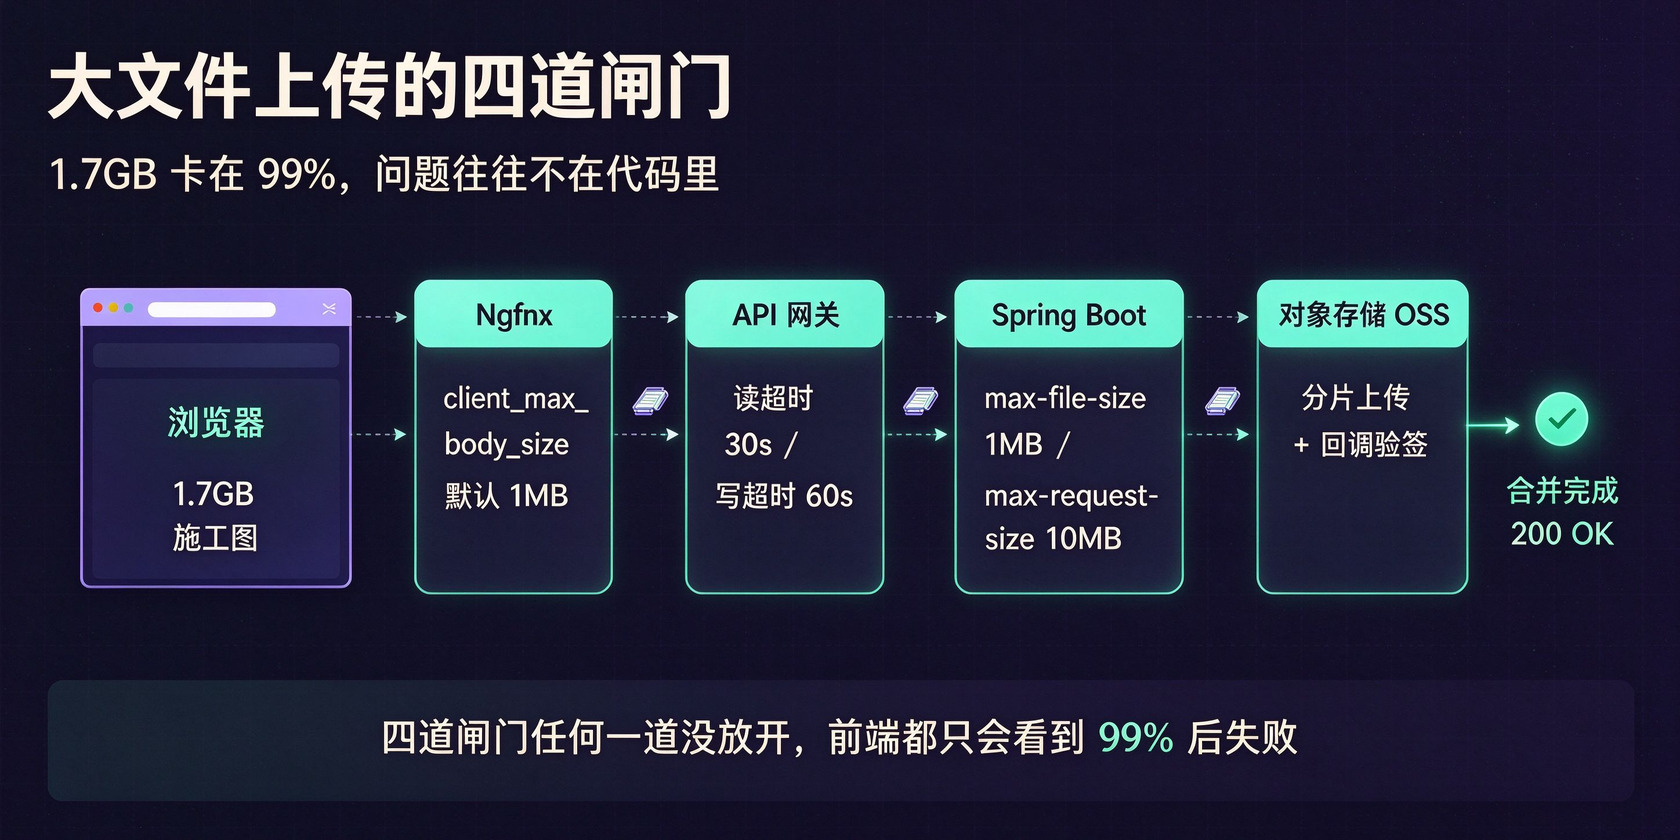
上周有个客户传一份 1.7GB 的施工图压缩包,进度条走到百分之九十九停了,刷新页面从头再来。他以为是网速问题,换了专线,还是一样。真正的原因是整条链路上有好几个默认限制,单次请求根本扛不住这个体积。
很多团队第一反应是把 Nginx 的 client_max_body_size 调大,调到 2G、4G,然后发现超时、内存、临时盘的问题一个接一个冒出来。大文件上传要做的事,是把一次不可控的长事务拆成若干可重试的小事务。分片、断点、秒传,都是围绕这件事展开的。
一、先把链路上的四道限制拆开
第一道在网关。Nginx 默认 client_max_body_size 是 1MB,很多项目改到 10MB 或 50MB 就停了,超过直接返回 413。负载均衡和 WAF 还各有一层请求体上限,云厂商的网关常见 100MB 封顶,这些值不会写在业务代码里,出问题时也不容易想到。
第二道在应用容器。Spring Boot 的 multipart 默认单文件 1MB、单请求 10MB,改 spring.servlet.multipart.max-file-size 只能解决表单上传。控制器里只要写了 MultipartFile,请求进方法之前容器已经把整个体解析完,临时文件先落一遍盘,再大的内存也扛不住几个并发。Tomcat 还有一个 maxSwallowSize,默认 2MB,服务端拒收大请求时剩余字节吞不掉,连接会被直接重置,前端看到的是 connection reset,不是 413。
第三道在超时。网关的读超时常见 30 秒到 60 秒,应用层也有自己的请求超时。传一个 2GB 文件,按 5MB/s 的上行速度要将近七分钟,中间任何一跳超时,浏览器拿到的都是失败,用户只能重传。
第四道在存储。对象存储的单次 PutObject 通常有 5GB 上限,超过就得走分片上传。更麻烦的是失败重传的成本,1.7GB 传三次就是 5GB 流量,十个用户同时重传,出口带宽先被打满,后面的请求跟着排队。
所以分片不是为了让代码看起来高级,而是把失败的影响范围缩小到一片。一片 8MB 传失败,只补这一片,不用把 1.7GB 重新来一遍。这个账算清楚,后面的设计才有意义。
二、分片不是切完就完,合并顺序才是坑
分片大小要结合文件体积和网络来定。常见做法是 5MB 到 10MB,2GB 的文件切成 256 片左右,单片重传的成本可以接受,请求数量也不会夸张。切到 1MB 会让请求数翻八倍,连接复用和鉴权的开销盖过收益;切到 64MB 又会让一次失败重传半分钟,弱网下体验很差。
客户端并发上传通常控制在 3 到 4 片,服务端也要有每用户的并发上限。有人把并发开到 16,结果是把上行带宽切成 16 份,每片都慢,整体时间反而更长,还容易触发网关限流。
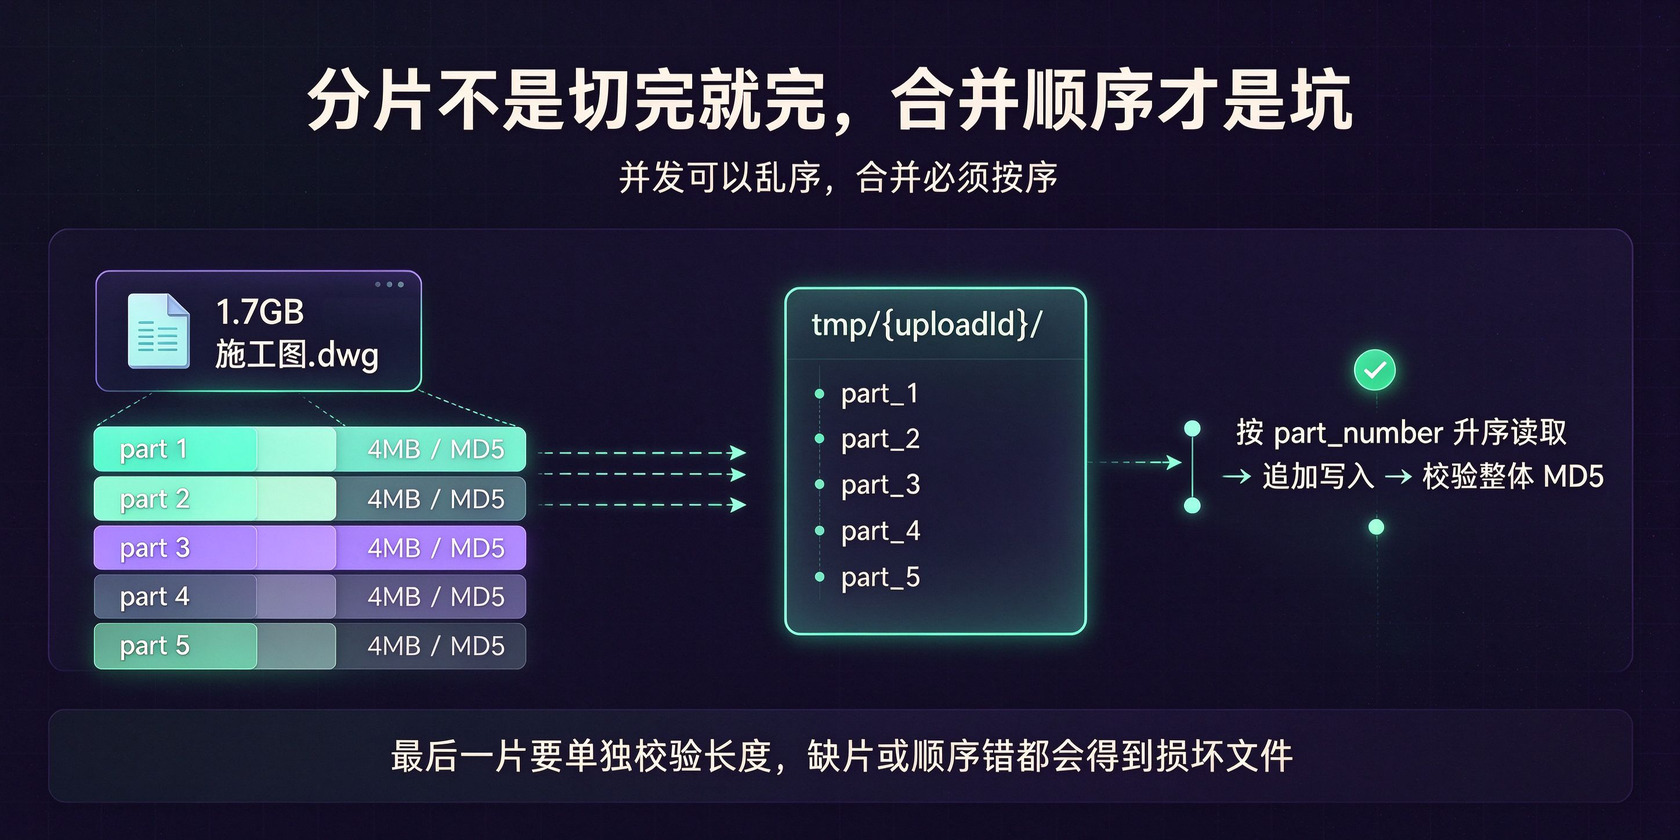
每片必须带两个信息,片序号和分片校验值。片序号从 1 开始连续递增,服务端按序号落临时文件,不要用到达时间命名。网络乱序是常态,第 7 片可能比第 3 片先到,按时间合并一定出错。
分片接口直接读原始请求流,请求头用 application/octet-stream,不要用 multipart/form-data。后者会先被 Spring 的 MultipartResolver 解析一遍,等于把流式落盘又变回整包缓冲。
@PutMapping("/api/upload/{uploadId}/part/{partNo}")
public ResponseEntity<?> uploadPart(@PathVariable String uploadId,
@PathVariable int partNo,
HttpServletRequest request) throws IOException {
UploadSession session = store.get(uploadId);
if (session == null || session.getStatus() != Status.UPLOADING) {
return ResponseEntity.notFound().build();
}
long expected = partNo < session.getTotalChunks()
? session.getChunkSize()
: session.getFileSize() - session.getChunkSize() * (session.getTotalChunks() - 1);
Path temp = store.partPath(uploadId, partNo);
try (InputStream in = request.getInputStream()) {
Files.copy(in, temp, StandardCopyOption.REPLACE_EXISTING);
}
long size = Files.size(temp);
if (size != expected) {
Files.deleteIfExists(temp);
return ResponseEntity.badRequest()
.body(Map.of("error", "part size " + size + " != " + expected));
}
store.savePart(uploadId, partNo, size, null);
return ResponseEntity.ok(Map.of("partNo", partNo, "size", size));
}
这段代码里有两个细节。最后一片的大小不是固定值,要用总大小减去前面所有片的长度,很多合并失败就败在这里。落盘之后立刻比对大小,不合格的片直接删掉,不能让脏片进入合并阶段。
落盘记录用一张单独的分片表,主键是上传会话加片序号,重复上传同一片时覆盖旧记录。这样客户端重试同一片不会产生两条数据,合并时也不会因为重复片把顺序算乱。
CREATE TABLE upload_session (
id            BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
tenant_id     BIGINT UNSIGNED NOT NULL,
upload_id     CHAR(32) NOT NULL,
file_hash     CHAR(64) NOT NULL,
file_size     BIGINT NOT NULL,
chunk_size    INT NOT NULL,
total_chunks  INT NOT NULL,
status        TINYINT NOT NULL DEFAULT 0,
storage_key   VARCHAR(512) DEFAULT NULL,
oss_upload_id VARCHAR(256) DEFAULT NULL,
created_at    DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
updated_at    DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
expires_at    DATETIME NOT NULL,
PRIMARY KEY (id),
UNIQUE KEY uk_upload (upload_id),
UNIQUE KEY uk_file (tenant_id, file_hash, file_size),
KEY idx_expire (status, expires_at)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
CREATE TABLE upload_part (
upload_id  CHAR(32) NOT NULL,
part_no    INT NOT NULL,
part_size  INT NOT NULL,
etag       VARCHAR(128) DEFAULT NULL,
created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
PRIMARY KEY (upload_id, part_no)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
合并前先做一次完整校验,片数对不对、序号连不连续、每片大小对不对、总大小等不等于声明值。四项里任何一项不过,直接返回冲突,不要进入写存储的步骤。合并完成后如果走对象存储,再把每片的 ETag 按序号拼成 CompleteMultipartUpload 的请求体,让存储侧再校验一次。
List<UploadPart> parts = store.listParts(uploadId);
if (parts.size() != session.getTotalChunks()) {
return ResponseEntity.status(HttpStatus.CONFLICT)
.body(Map.of("error", "missing parts"));
}
for (int i = 1; i <= session.getTotalChunks(); i++) {
long want = i < session.getTotalChunks()
? session.getChunkSize()
: session.getFileSize() - session.getChunkSize() * (session.getTotalChunks() - 1);
UploadPart p = parts.stream()
.filter(x -> x.getPartNo() == i)
.findFirst().orElse(null);
if (p == null || p.getPartSize() != want) {
return ResponseEntity.status(HttpStatus.CONFLICT)
.body(Map.of("error", "part " + i + " invalid"));
}
}
int affected = jdbc.update(
"UPDATE upload_session SET status = 2 WHERE upload_id = ? AND status = 1", uploadId);
if (affected == 0) {
return ResponseEntity.status(HttpStatus.CONFLICT)
.body(Map.of("error", "already merging"));
}
合并这件事必须幂等。用户看到失败会连点两次完成按钮,两个请求同时进来,一个在写文件,一个也在写,最后得到一个半截文件。上面那条带状态条件的更新把并发挡住了,只有一个请求能把状态从上传中改成合并中,另一个直接返回已在处理。
三、秒传靠的是哈希加一张状态表,不是玄学
秒传的判断条件很朴素,同一个租户下,同样的大小和同样的内容哈希已经完整落过盘。服务端拿到客户端算的 SHA-256,先查状态表,命中就直接返回文件标识,不传字节。
哈希怎么算有讲究。2GB 的文件在浏览器里做全量 SHA-256,普通机器要几十秒,主线程会卡住,进度条也不动。实际做法是放到 Web Worker 里流式读取,边读边算,前端给一个计算进度的提示。也可以先用文件大小、首尾各 1MB 的抽样哈希做一次快速预判,命中再用全量哈希确认,少一次等待。
状态表的唯一键是租户、文件哈希、文件大小三项。状态值统一用 0 待上传、1 上传中、2 合并中、3 已完成、9 失败,判断能不能秒传只看 3,别拿 1 或 2 当完成。不要只按哈希去重,不同租户的数据不能互相可见,跨租户复用会把别人的文件标识返回给攻击者。哈希本身就是内容的指纹,知道哈希的人能不能拿到文件,取决于租户边界和权限校验,这两层不能省。
SELECT storage_key
FROM upload_session
WHERE tenant_id = @tenant
AND file_hash = @hash
AND file_size = @size
AND status = 3
LIMIT 1;
两个用户同时传同一个文件,会同时查不到记录,然后各自创建会话。唯一键在这里起作用,先插入的成功,后插入的拿到重复键错误,服务端捕获之后回查已有会话,把上传标识返回给第二个用户。不要用先查后插再补事务的写法,并发下一定会漏。
秒传还有一个容易被忽略的点,客户端声明的哈希不能无条件相信。正常流程里,文件是服务端合并完之后自己再算一遍哈希,落库的也是服务端算的值。秒传命中时比对的是客户端哈希和服务端已存哈希,两者一致才返回。如果业务对文件内容敏感,还可以要求客户端上传第一片做抽样校验,确认它真的持有这份文件。
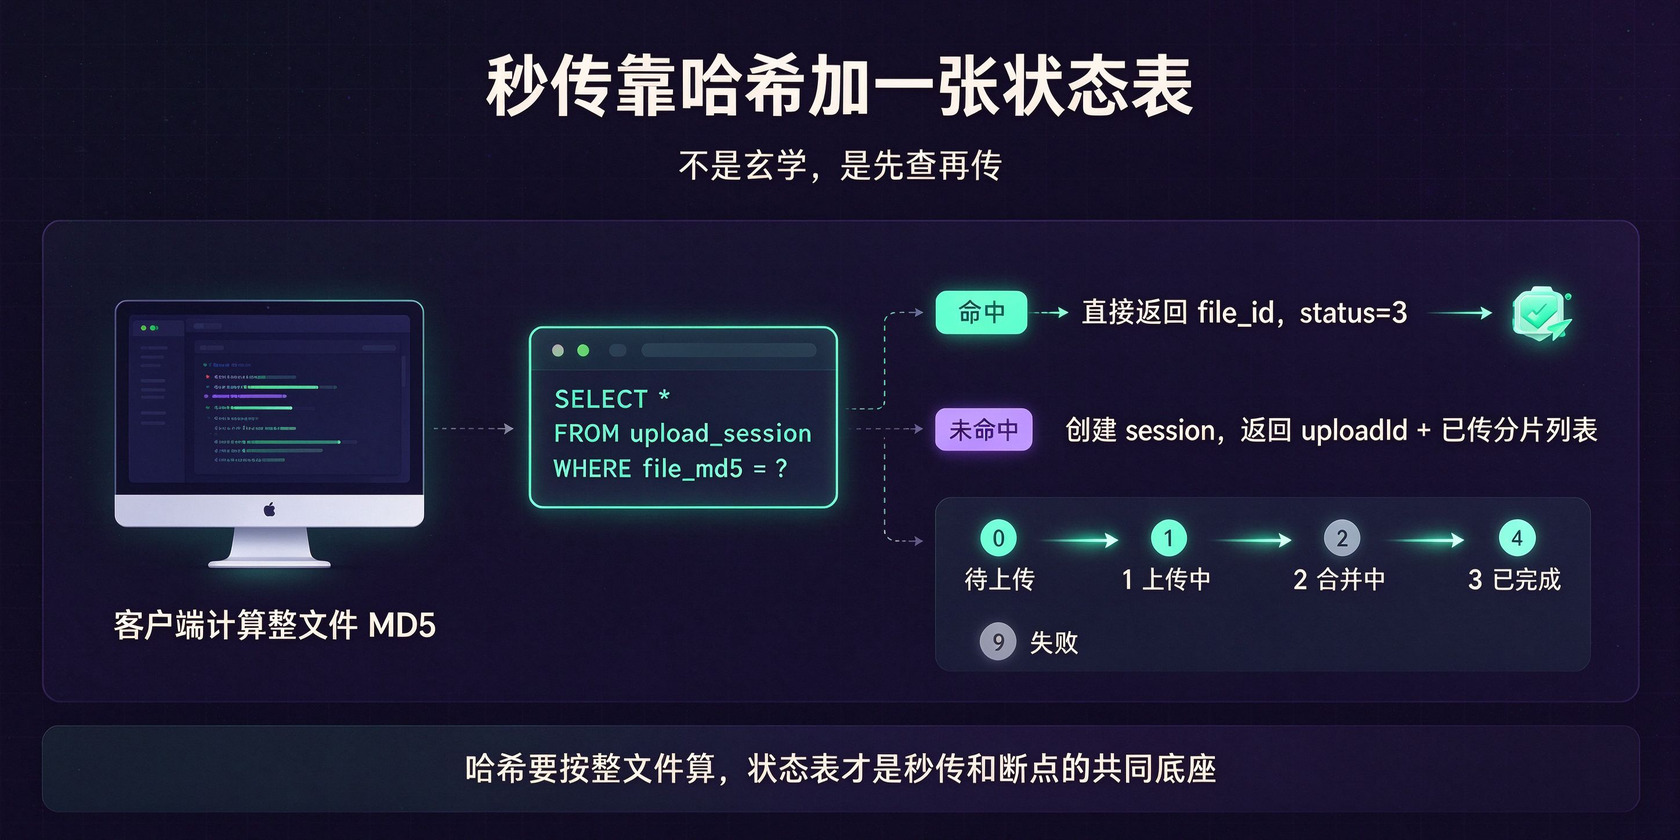
秒传省的是带宽和时间,不是存储。同一个文件在对象存储里只留一份,数据库里记的是引用和业务归属。真要删文件,得先确认没有业务还在引用,否则一个业务删了,另一个业务的附件跟着 404。
四、断点续传和清理,才是长期跑得稳的部分
断点续传的关键不是记住进度,而是让客户端能准确知道还缺哪几片。上传会话创建后,客户端先调一次状态接口,服务端返回已落盘且校验通过的片序号列表,客户端只补缺失的片。列表不要返回布尔值,返回具体序号,前端才能并发出三到四个请求。
状态接口还要返回会话的过期时间。超过二十四小时没完成的会话,临时分片会被清理,客户端拿到过期状态后重新初始化,不要继续往一个已经被清空的会话里传片。
合并的并发控制前面提过,用状态条件更新就够了。这里补一个失败回滚的细节,合并到一半写存储失败,会话状态要退回上传中,让客户端可以重试,而不是卡在合并中永远不动。退回之前先清掉写了一半的目标文件,避免下一次合并读到脏数据。
清理任务要独立于业务请求跑。每十分钟扫一批过期会话,先调对象存储的 AbortMultipartUpload 把未完成的分片上传终止,再删本地临时目录和分片记录。对象存储的未完成分片会一直占容量,不主动终止,账单会慢慢涨,这一点在本地磁盘上看不出来。
SELECT upload_id, storage_key, oss_upload_id
FROM upload_session
WHERE status IN (0, 1, 2)
AND expires_at < NOW()
ORDER BY expires_at
LIMIT 200;
@Scheduled(fixedDelay = 10 * 60 * 1000)
public void cleanExpiredSessions() {
List<UploadSession> batch = store.findExpired(200);
for (UploadSession s : batch) {
if (s.getOssUploadId() != null) {
oss.abortMultipartUpload(bucket, s.getStorageKey(), s.getOssUploadId());
}
store.deleteSession(s.getUploadId());
}
}
清理不要用 DELETE 直接扫全表,先按过期时间走索引取一批,再逐条处理。只取未完成且已经过期的会话,别把刚创建还没到期的会话带上。
如果走 OSS 或 S3 直传,服务端的角色会变轻,但校验不能省。客户端拿临时凭证直传,完成后回调业务服务,业务侧要验签、核对文件大小和 Content-Type,再调一次 HEAD 确认对象真的存在。只信回调里的 JSON,等于把文件归属交给客户端决定,签名和大小复核是最后一道门。
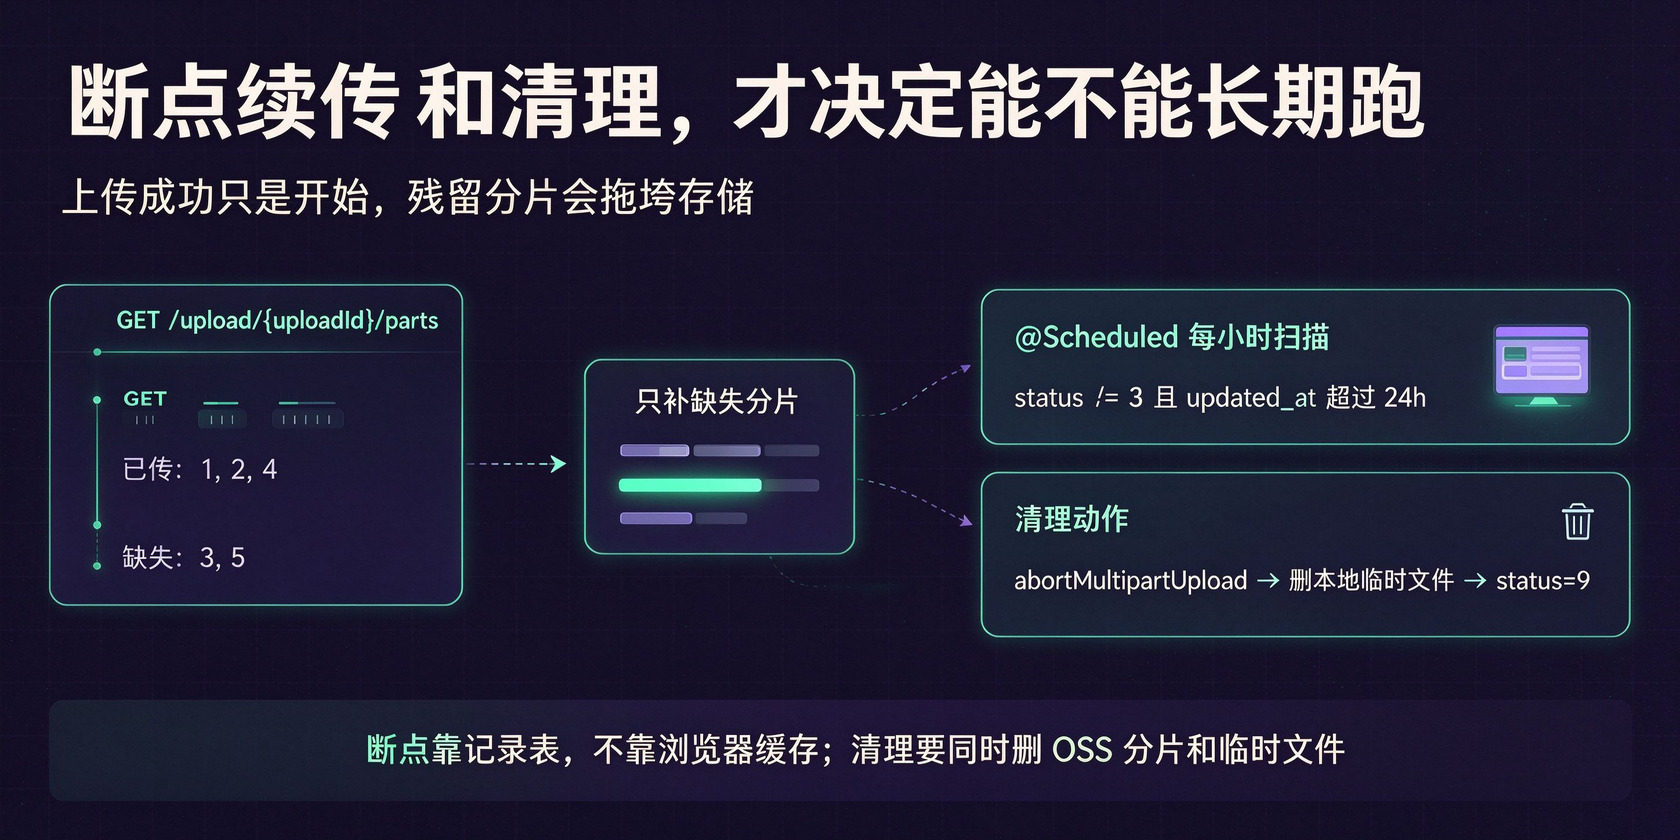
这套东西不用一上来就全做。先看自己业务的文件大小分布,九成文件在 100MB 以下,单次上传加失败重试就够用,先把网关和容器的请求体上限、超时调对,别让 413 和 30 秒超时挡在门口。
超过 500MB 的文件开始变多,再上分片和断点。分片大小从 8MB 起步,并发控制在 4 以内,合并前把片数、序号、单片大小、总大小四项校验写死。秒传只在同租户内做,状态表带过期时间,清理任务记得终止对象存储的未完成分片。最后一步是合并后的哈希复核,这一步做了,后面排查问题才有依据。

 在线
 电话
 微信
 需求
 TOP