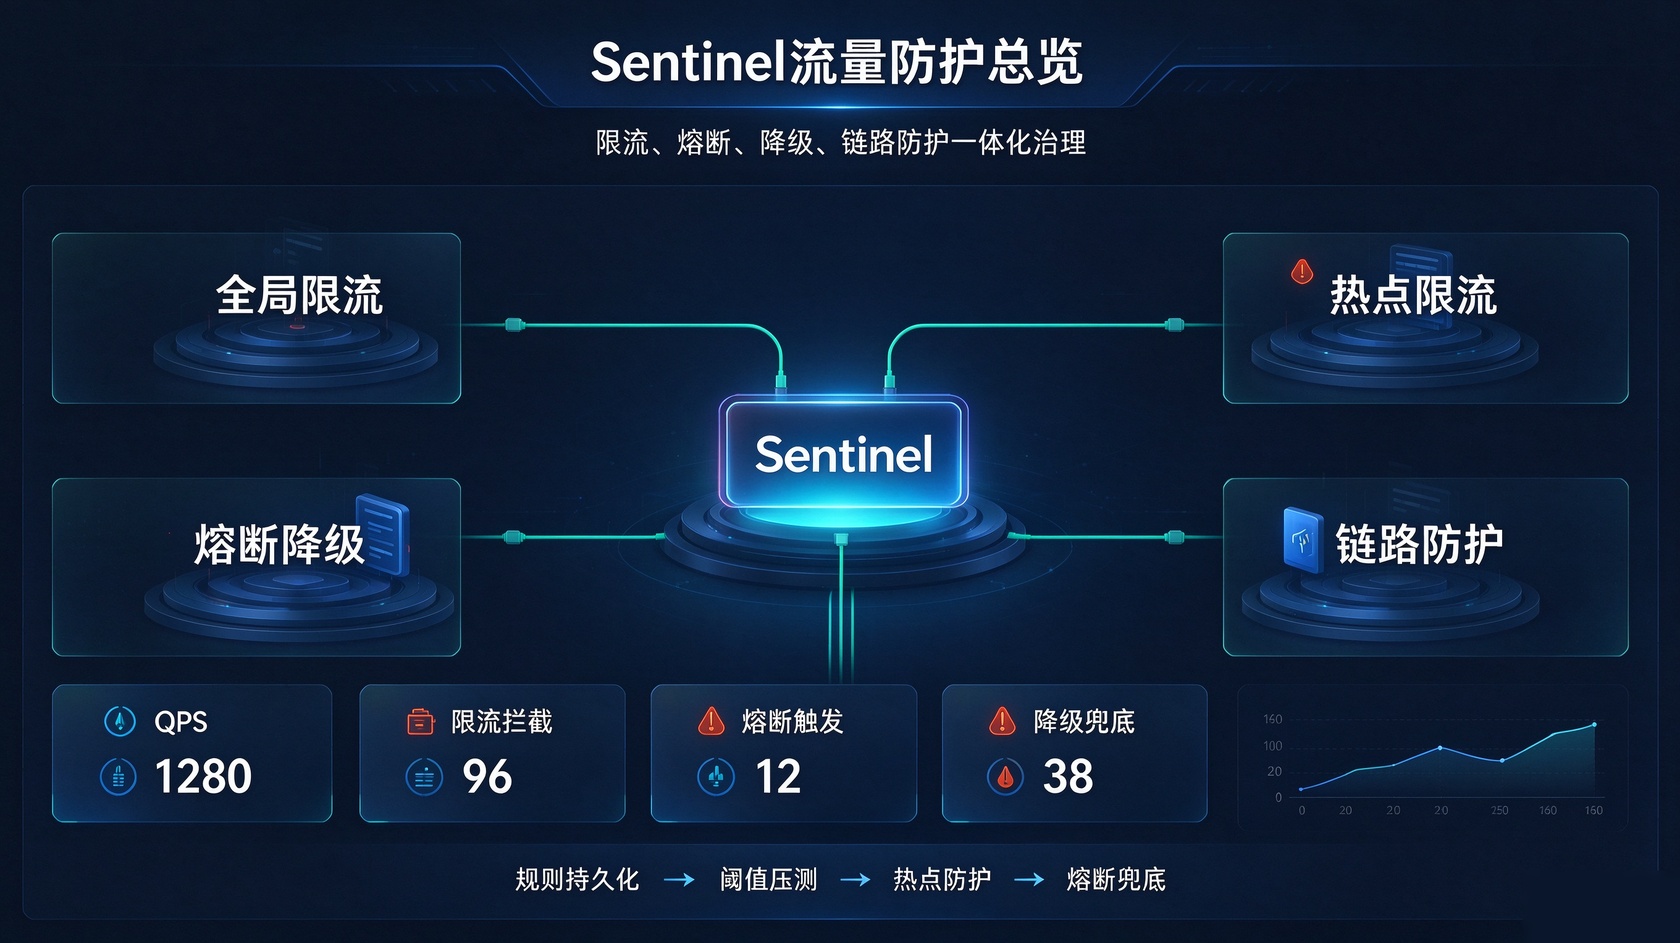
做微服务架构久了,我最大的感受是:流量防护从来不是锦上添花,而是线上故障的最后一道保命闸门。
Sentinel 凭借轻量、侵入性低、实时防护的优势,基本成为国内微服务的标配容错组件。但我接触过绝大多数团队,接入方式都非常敷衍,仅仅是引入依赖、控制台简单点配几条规则就草草上线。
平时日常流量平稳,一切看似正常无问题。可一旦遇到营销活动、流量突增、下游服务抖动,各种隐性问题集中爆发:限流完全不生效、熔断迟迟不触发、服务越跑越卡、甚至直接级联雪崩。
我们之前线上就踩过一次非常典型的坑:大促高峰期流量暴涨,本该拦截的突发流量完全没被挡住。事后复盘才发现,控制台临时配置的规则仅存在服务内存中,扩容节点后新实例无任何防护配置,直接裸奔承接流量,差点引发全线故障。
很多 Sentinel 导致的线上事故,看似诡异,本质都是配置不规范、认知不到位、场景不匹配。
一、线上高频隐形坑:那些看似正常实则致命的配置误区
在所有问题里,规则未持久化是翻车率最高的问题。
很多开发习惯直接在控制台手动配置限流、熔断规则,这种方式只适合本地调试验证。生产环境中,服务重启、集群扩容、节点重启都会清空内存规则,所有流量防护直接失效。等到流量高峰到来,服务毫无容错能力,故障风险直线飙升。
生产环境的标准做法,是将所有防护规则统一托管至 Nacos 配置中心,实现规则持久化、动态推送、集群全局同步。无论服务重启还是扩容,防护规则都能实时加载、永久生效,从根源避免裸奔问题。
spring:
  cloud:
    sentinel:
      datasource:
        flow-rule:
          nacos:
            server-addr: 127.0.0.1:8848
            data-id: sentinel-flow-rule.yml
            rule-type: flow
其次是限流阈值的主观配置问题。很多人不做压测摸底,仅凭经验随手填写 QPS 数值,极易出现两种极端:阈值设置过低,正常用户请求被误拦,直接影响业务体验;阈值设置过高,突发恶意流量完全挡不住,限流形同虚设。
结合多年生产经验,最稳妥的方式是通过压力测试摸清单实例最大承载上限,取峰值 QPS 的 70% 作为正式限流阈值。预留三成缓冲空间,既能稳稳护住服务不被打崩,又能最大程度兼容正常业务波动。
熔断参数的调试,最考验对业务场景的理解,也是最容易配置失衡的地方。熔断判定时长、异常比例、窗口期时间,但凡一个参数不合理,就会出现“小抖动频繁熔断、大故障不熔断”的尴尬情况。
针对常规业务接口,我们线上统一采用慢调用比例熔断策略:接口响应超时 800ms 判定为慢请求,1 分钟内慢调用占比超过 20% 立即触发熔断;默认 10 秒熔断窗口期,窗口期结束后自动进入半开状态,通过少量请求探测服务健康度,恢复正常则关闭熔断,兼顾容错性与自愈能力。
除此之外,热点流量防护缺失是很多项目的盲区。
秒杀商品、热门活动、单个用户高频刷接口等场景,往往不是全局流量超标,而是单个参数带来的集中爆破流量。单纯依赖全局限流,无法精准拦截热点请求,极易出现单个热点流量耗尽服务资源,连带普通用户请求一起卡顿报错。核心活动接口,必须单独配置热点参数限流,实现精准防护。
还有一个细节极易被忽略:配置了熔断规则,却没有兜底降级逻辑。
很多团队只关注“怎么拦截”,却忽略了“拦截之后如何展示”。一旦触发限流或熔断,程序直接抛出原生异常,前端返回 500 错误,页面直白报错,用户体验极差。统一封装全局限流异常处理器,友好兜底提示,是生产环境必不可少的优化细节。
@Component
public class GlobalBlockHandler implements BlockExceptionHandler {
    @Override
    public void handle(HttpServletRequest request, HttpServletResponse response, BlockException e) {
        ResponseResult.fail("系统繁忙,请稍后再试");
    }
}
最后还要注意链路防护问题。只做接口全局限流远远不够,微服务调用链路复杂,上游流量正常不代表下游服务能扛住。如果不对薄弱下游服务做链路限流,上游正常流量持续涌入,依然会压垮下游,引发全链路级联故障。
二、流量防护的落地思路:分层防护,拒绝一刀切
真正稳定的流量防护体系,从来不是堆砌规则,而是分层精准防护。
我们落地的核心思路是:优先通过热点参数限流,拦截单点爆破的异常流量;再针对核心调用链路做针对性防护,保护性能薄弱的下游服务;最后搭配全局 QPS 限流和熔断降级兜底。由点到面层层防护,既不会一刀切误杀正常流量,又能精准拦截故障流量。
三、线上故障高效排查思路
遇到 Sentinel 相关故障,不用盲目修改参数试错,按照固定思路排查效率最高。
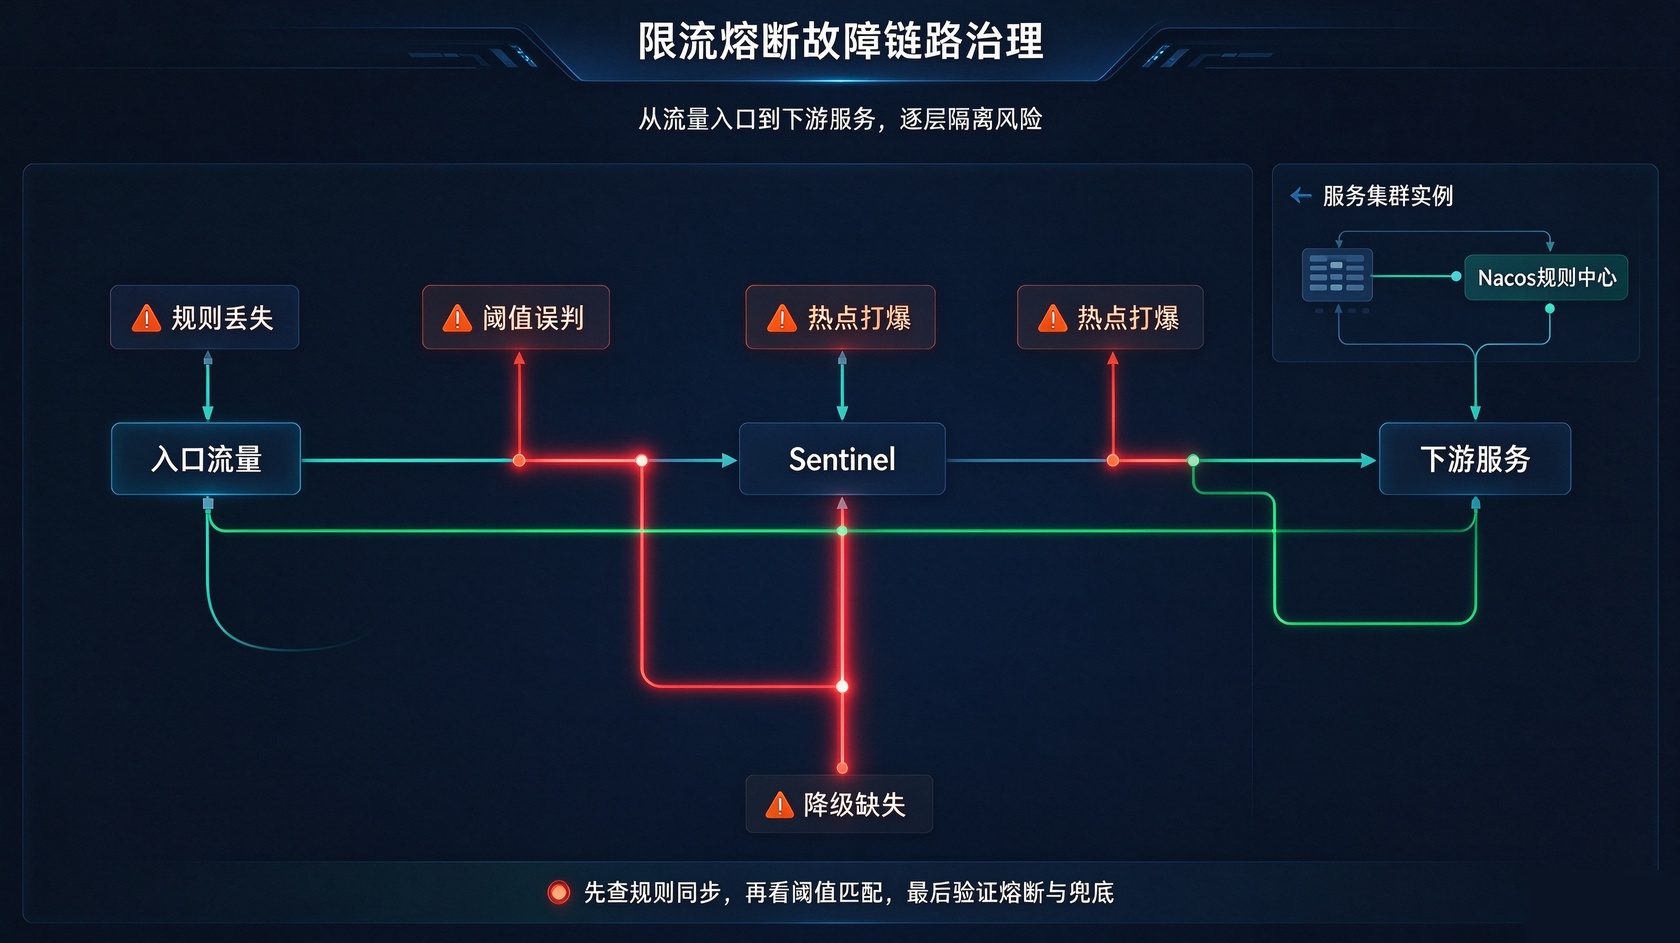
首先观察现场现象,区分是“正常流量被误拦”还是“异常流量拦不住”。第一步优先核对规则同步状态,确认 Nacos 配置是否正常加载,实例重启后规则是否保留,先排除规则丢失这类基础低级问题。
随后对照监控面板,查看实时 QPS、限流拦截次数、慢调用占比,判断是阈值不合理,还是熔断触发条件不匹配。所有配置调整完成后,务必通过压测模拟流量突增、下游故障等极端场景,验证防护效果,杜绝线上盲目改配置。
四、线上落地的核心经验与规范
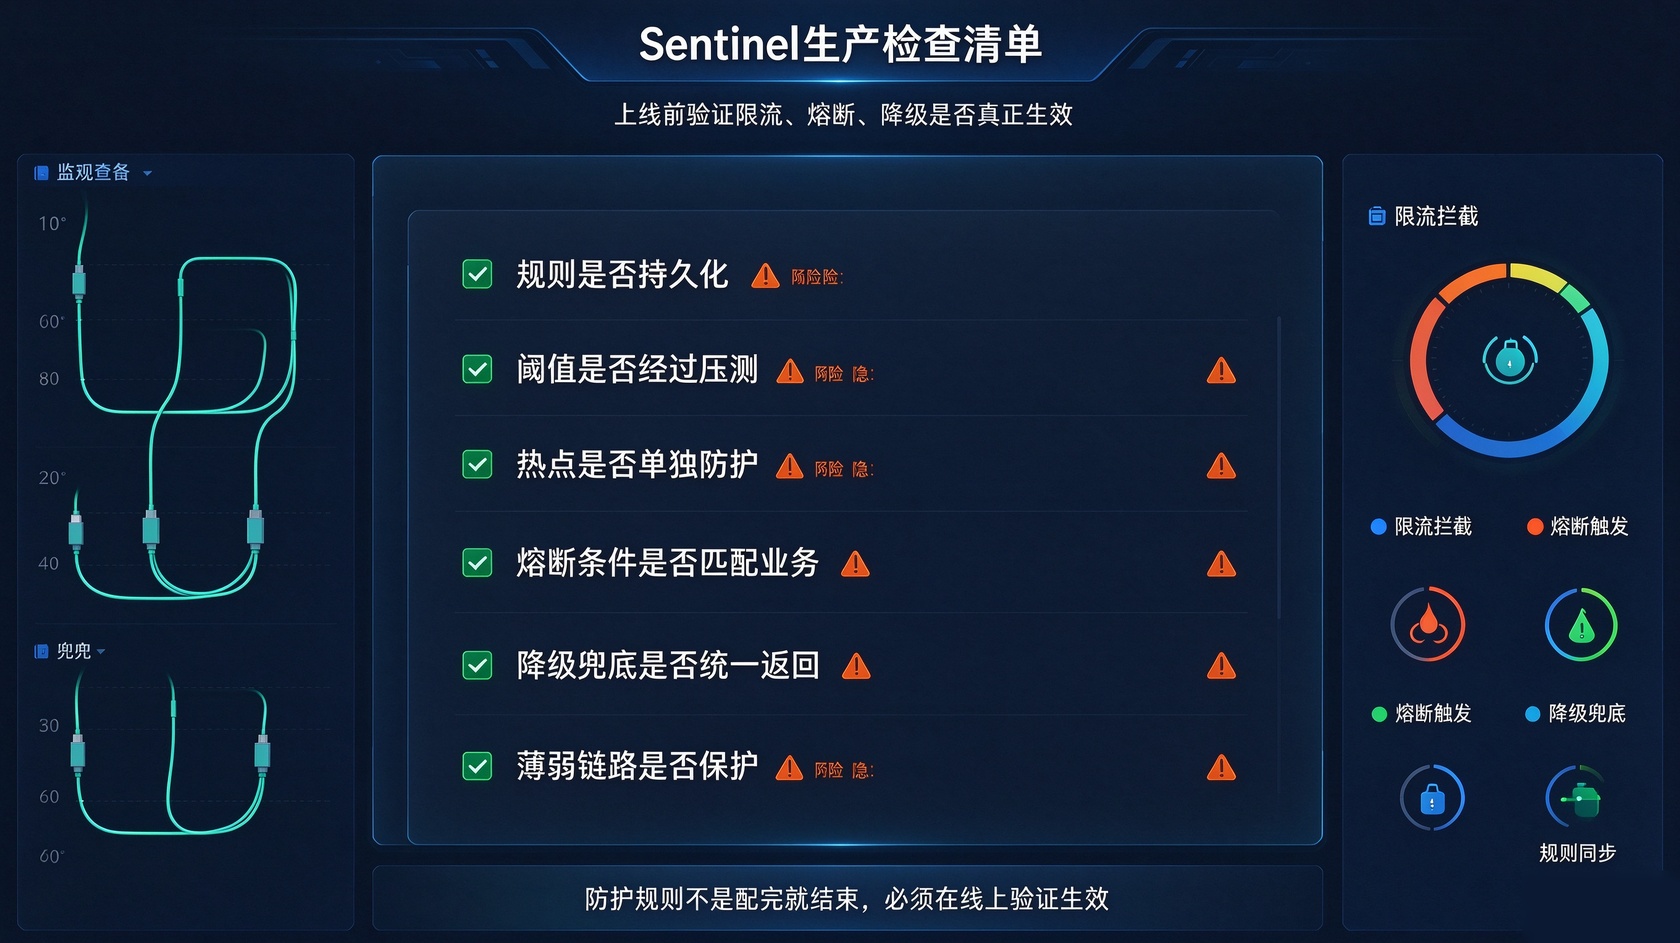
复盘多年线上 Sentinel 踩坑经历,其实绝大多数问题都可以提前规避。
生产环境坚决杜绝控制台临时配参,所有规则统一 Nacos 持久化;限流阈值以压测数据为依据,拒绝主观经验判断;热点接口必配参数限流,精准拦截单点流量攻击;所有防护接口统一配置降级兜底,避免直白报错。
同时优先使用慢调用比例熔断,适配真实业务波动;梳理全链路依赖,针对性保护薄弱下游服务;日常持续监控限流、熔断指标,定期清理无效过期规则,避免规则堆积冗余。
五、总结
Sentinel 的线上失效,从来不是组件本身的性能问题,大多是配置不规范、防护思路单一、忽略业务场景导致的人为故障。
流量防护的核心价值,不是限制用户访问,而是在系统面临极端流量和故障冲击时,主动隔离风险、保护核心业务、阻止故障扩散。做好分层防护、规范配置、精准兜底,才能让 Sentinel 真正成为微服务的稳定护盾,彻底杜绝服务雪崩类线上事故。

 在线
 电话
 微信
 需求
 TOP